Origine et types d'hallucinations
Non, vous n’hallucinez pas. Ce texte est bien réel. Il vous explique un phénomène courant et pourtant méconnu…
Qu’est-ce qu’une hallucination ?
Une intelligence artificielle (IA) peut produire des informations fausses : inventer une référence bibliographique, attribuer une citation à une personne qui ne l’a jamais prononcée, donner une date erronée ou décrire un événement qui n’a jamais eu lieu. Elle peut même fournir des explications très convaincantes pour justifier des affirmations qui ne reposent sur rien.
Ce phénomène est appelé hallucination de l’IA (rien de médical, c’est juste une métaphore !). Le terme ne désigne pas uniquement les erreurs factuelles produites par un système : il souligne que celui-ci peut générer un contenu cohérent, mais qui ne correspond pas à la réalité. Le phénomène concerne les textes, mais aussi les images, les sons et les vidéos créés ou modifiés par l’intelligence artificielle.
Pourquoi parler d’hallucination plutôt que d’erreur ?
Une erreur est un terme général qui désigne un résultat incorrect. Le terme « hallucination » met l’accent sur trois particularités.
- L’IA peut inventer des éléments plutôt que simplement se tromper dans un calcul ou une information connue.
- Le contenu produit peut sembler parfaitement plausible. Une réponse bien rédigée ou une photographie réaliste ne constituent pas des preuves de leur authenticité. La qualité de la présentation peut même rendre la détection du problème plus difficile.
- Ces productions sont involontaires. Une IA générative cherche à produire un contenu conforme au script, selon les régularités qu’elle a apprises et les mécanismes qui la gouvernent. Elle peut donc fabriquer une réponse crédible sans disposer des éléments nécessaires pour en garantir l’exactitude.
Causes
Les hallucinations ont plusieurs origines, qui peuvent se combiner.
- L’apprentissage à partir de données imparfaites : les IA génératives sont entraînées sur de grandes quantités de données qui peuvent contenir des erreurs, des contradictions, des informations obsolètes ou des représentations biaisées. De plus, apprendre à partir d’exemples ne signifie pas disposer d’une connaissance exhaustive du monde. Un modèle de langage apprend notamment à prévoir quels éléments linguistiques sont susceptibles de suivre un contexte donné. Cette capacité lui permet de rédiger des textes remarquablement fluides, mais elle ne garantit pas que chaque affirmation soit vraie.
- La recherche d’une réponse plausible : lorsqu'un utilisateur pose une question, un modèle de langage cherche à produire une réponse adaptée au contexte. Si les informations dont il dispose sont insuffisantes, il peut néanmoins poursuivre la génération en proposant des éléments vraisemblables. Imaginons qu'on lui demande le titre d'un article scientifique publié par un chercheur donné. Si le modèle ne connaît pas cet article, il peut assembler un titre plausible, un nom de revue et une année de publication. Le résultat ressemble alors à une référence authentique, mais sans correspondre à un document réel.
- Le manque de contexte et les ambiguïtés : une question imprécise peut être mal interprêtée.
- Les limites des modèles et de leur évaluation : les systèmes génératifs sont complexes et leur comportement dépend de nombreux paramètres (données d'entraînement, architecture, méthode de génération, consignes et mécanismes de contrôle…). Les méthodes d'évaluation peuvent détecter certaines erreurs, mais il est difficile de tester toutes les questions et toutes les situations possibles. Une réponse correcte dans un contexte peut devenir incorrecte après une reformulation ou l'ajout d'une contrainte, par exemple.
Pas seulement le texte !
Avec les modèles multimodaux, capables de produire ou de traiter plusieurs types de contenus, les hallucinations prennent des formes variées.
Dans les textes, elles se traduisent par des faits inventés, des chiffres inexacts, des citations fictives ou des raisonnements fondés sur des prémisses fausses.
Les IA capables de générer du code sont elles aussi susceptibles de produire des hallucinations. Elles peuvent, par exemple, inventer le nom d'une fonction qui n'existe pas dans une bibliothèque, utiliser un paramètre non reconnu ou proposer une méthode appartenant à une autre version d'un logiciel. Le code produit peut sembler parfaitement cohérent et respecter les règles de syntaxe, tout en étant incapable de fonctionner correctement. Plus subtilement, il peut s'exécuter sans erreur apparente, mais effectuer des calculs incorrects ou produire des résultats inadaptés. Ces hallucinations s'expliquent par le fait que l'IA apprend des régularités dans le code existant sans garantir que chaque instruction proposée corresponde à une fonctionnalité réelle ou réponde correctement au problème posé. La compilation, les tests et la vérification de la documentation permettent de limiter ces risques, sans les éliminer totalement. Un programme qui fonctionne sur quelques exemples peut hélas contenir des erreurs dans d'autres situations.
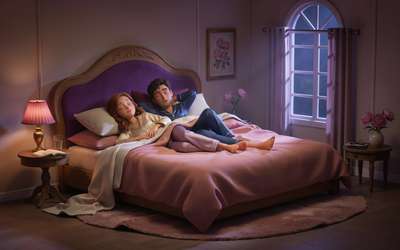
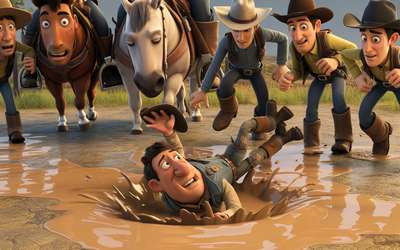
Un générateur d’image peut produire une scène en partie convaincante, mais comportant des incohérences : anatomie improbable, objets déformés, inscriptions illisibles ou détails incompatibles avec la situation représentée. Exemples...
Ici, les jambes du couple passent à travers la couverture :
Là, un cheval a clairement un visage humain !
Dans les vidéos, les difficultés sont encore plus nombreuses. Une vidéo générée peut présenter des mouvements peu naturels, des objets qui changent d'apparence ou des détails qui se modifient d'une image à l'autre. Par ailleurs, les systèmes capables de synchroniser les lèvres et la voix peuvent créer de fausses séquences dans lesquelles une personne semble prononcer des paroles qu'elle n'a pas dites.
Notez que toutes les imperfections visuelles ou audiovisuelles ne sont pas, à proprement parler, des hallucinations au sens retenu pour les modèles de langage. Le terme est employé plus largement pour désigner différentes productions trompeuses des systèmes génératifs.
Comment limiter les hallucinations ?
Il existe deux types de moyens pour un utilisateur de réduire les risques.
- La première repose sur les capacités humaines. Les chiffres, les citations, les références scientifiques, les informations juridiques et les affirmations importantes doivent être vérifiés. Pour les images et les vidéos, il faut faire preuve d’un bon sens de l’observation.
- Les détecteurs automatiques peuvent contribuer à repérer certains contenus artificiels, mais ils ne sont pas infaillibles.