Significativité d'une corrélation
Lorsqu'on étudie deux variables quantitatives, le coefficient de corrélation linéaire de Pearson, généralement noté \(r\), permet de mesurer l'intensité et le sens de leur liaison linéaire.
Mais comment l’interpréter s’il est calculé sur un échantillon ? Supposons que l'on observe une corrélation de 0,45 entre le temps consacré aux révisions et la note obtenue à un examen. Peut-on en conclure qu'il existe une corrélation dans la population d’où provient l'échantillon ?
Pour répondre à cette question, on réalise un test de significativité du coefficient de corrélation. On peut le considérer comme un test d’indépendance entre les deux variables (explicative et expliquée). Ici, nous nous limiterons au test bilatéral qui consiste à comparer le coefficient de corrélation de la population à zéro.
Hypothèses
L'hypothèse nulle, notée H0, est que le coefficient de corrélation dans la population est nul. L'hypothèse alternative, notée H1, est qu'il est différent de zéro :
\( H_0:\rho=0 \qquad H_1:\rho\ne 0 \)
Notation : \(\rho\) est le coefficient de corrélation dans la population tandis que \(r\) est calculé sur l'échantillon.
Le test cherche à déterminer si les données apportent suffisamment d'éléments pour rejeter l'hypothèse d'une corrélation linéaire nulle.
t de Student
Le coefficient \(r\) est calculé à partir d'un échantillon. Sa valeur varie donc d'un échantillon à l'autre, même si la corrélation réelle dans la population reste inchangée. Il faut tenir compte de cette variabilité pour déterminer si le coefficient observé est suffisamment éloigné de zéro.
C'est ici que surgit une vieille connaissance : le t de Student. Sous l'hypothèse nulle et sous certaines conditions, une transformation du coefficient de corrélation suit une loi de Student à \(n-2\) degrés de liberté, où \(n\) représente la taille de l'échantillon. La statistique de test est calculée à l'aide de la formule suivante :
\(\displaystyle{t=r\sqrt{\frac{n-2}{1-r^2}}} \)
Cette formule combine le coefficient de corrélation observé et la taille de l'échantillon. À coefficient égal, une taille d'échantillon plus importante conduit à une valeur absolue de t plus élevée et il devient plus sûr de mettre en évidence une corrélation non nulle.
La loi de Student permet ensuite de déterminer la probabilité d'obtenir une valeur de t au moins aussi éloignée de zéro que celle observée, si l'hypothèse nulle est vraie. Cette probabilité est la probabilité critique (p-value).
Dans un test bilatéral au seuil de \(5\,\%\), on rejette H0 si la p-value est inférieure à 0,05. De manière équivalente, on rejette H0 si la valeur absolue de la statistique calculée dépasse la valeur critique de la loi de Student, pour \(n-2\) degrés de liberté.
Exemple avec R
Prenons un exemple concret à partir du jeu de données mtcars, fourni avec R. Il rassemble des caractéristiques de 32 modèles de voitures, notamment leur poids (wt) et leur consommation exprimée en miles par gallon (mpg). Plus cette dernière valeur est faible, plus la consommation est élevée.
Nous cherchons à savoir si le poids et la consommation présentent une corrélation linéaire significative dans la population étudiée.
Note : contrairement à la pratique habituelle de ce site, nous avons jugé inutile de reproduire les données car si vous disposez de R vous pouvez reproduire les résultats.
Avec R, c’est la fonction cor.test() qui réalise le test de corrélation. Nous devrons lui indiquer les noms des deux variables, le coefficient de corrélation et le caractère bilatéral du test.
# mtcars est fourni avec R, aucun fichier à importer
data(mtcars)
# Calcul du coefficient de corrélation de Pearson
r <- cor(mtcars$wt, mtcars$mpg)
cat("Coefficient de correlation :", round(r, 4), "\n")
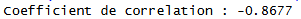
Le coefficient montre une forte corrélation linéaire négative : les voitures les plus lourdes sont les plus gourmandes en carburant.
#. Test bilatéral de corrélation
test <- cor.test(mtcars$wt, mtcars$mpg,
method = "pearson",
alternative = "two.sided",
conf.level = 0.95)
# Affichage des résultats complets
print(test)
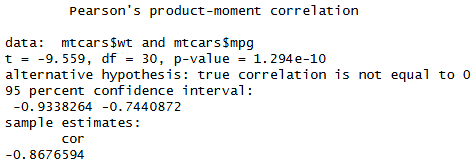
La p-value est très inférieure au seuil de \(5\,\%.\) Nous rejetons donc l'hypothèse nulle d'une corrélation linéaire nulle. L'intervalle de confiance à \(95\,\%\) ne contient pas non plus zéro, ce qui va dans le même sens.
# Comparaison avec la valeur critique
t_crit <- qt(0.975, df = ddl)
cat("Valeur critique a 5 % :", round(t_crit, 4), "\n")
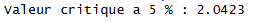
Dans le script, qt(0.975, df = ddl) calcule la valeur critique de Student pour un test bilatéral au seuil de \(5\,\%.\) Le nombre 0,975 correspond à \(1-\frac{0,05}{2}\), puisque les \(5\,\%\) sont répartis entre les deux extrémités de la distribution.
dif (abs(t_calc) > t_crit) {
cat("Conclusion : corrélation significative au seuil de 5 %.\n")
} else {
cat("Conclusion : corrélation non significative au seuil de 5 %.\n")
}
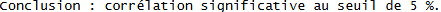
Vérification. Remplaçons les valeurs dans la statistique du test.
\( t\) \(=\) \(-0,868\sqrt{\frac{30}{1-(-0,868)^2}}\) \( t\approx\) \(-9,56 \)
On retrouve bien la statistique fournie par R, à l'arrondi près.
Pour un test bilatéral au seuil de \(5\,\%\) et 30 degrés de liberté, la table de Student donne une valeur critique d'environ 2,042. Il faut comparer la valeur absolue de la statistique calculée à cette valeur : \(|t|=9,56 > 2,042 \)
La statistique observée se situe donc dans la zone de rejet de l'hypothèse nulle. On conclut que la corrélation est statistiquement significative au seuil de \(5\,\%.\)
On peut même aller plus loin. La valeur critique bilatérale au seuil de \(0,1\,\%\) est d'environ 3,385. Comme \(9,56>3,385\), la p-value est inférieure à 0,001. La table permet donc de confirmer que le résultat est hautement significatif, même si elle ne donne pas ici la p-valeur précise calculée par R.